Thursday, June 14, 2018

Qual grupo da Copa do Mundo de 2018 é mais difícil?


Após o sorteio dos grupos da Copa do Mundo da FIFA de 2018, é comum ouvir amantes do futebol, perguntarem: “Qual foi o grupo mais difícil ?” .

Vamos tentar responder a essa pergunta, de forma objetiva, utilizando o modelo de simulação de jogos de futebol do site de previsões PollingData (http://www.pollingdata.com.br/), o qual leva em consideração todos os jogos entre seleções (oficiais e amistosos) realizados desde 2014. Com esse modelo  é possível estimar a probabilidade de cada seleção se classificar para as oitavas-de-final da Copa (ou seja, ficar nas 2 primeiras posições ao final dos jogos dessa fase).  Essa probabilidades estão na tabela abaixo, e serão utilizadas para responder a pergunta.


O passo mais importante para responder a pergunta é definir com objetividade o que quer dizer “grupo mais difícil”. Vários critérios diferentes podem ser utilizados, baseados em diferentes medidas. Um exemplo bastante  óbvio seria utilizar o ranking de seleções da FIFA, calculando o ranking médio por grupo. O problema é que esse critério está, na verdade, avaliando em quais grupos estão as seleções mais fortes, mas essa não é a resposta a pergunta proposta.

Um grupo pode ter um ranking médio bastante baixo, porém ainda ser muito difícil para seus participantes. O critério correto deve levar em conta a similaridade das seleções. Teoricamente, o grupo mais difícil seria aquele onde todas as seleções tivessem exatamente o mesmo nível técnico. O fato de ser um nível alto ou baixo não é relevante para os participantes que estão no grupo. O ranking médio poderia ser utilizado apenas para desempatar o ranking dos grupos, no caso de haver dois grupos com o mesmo score no critério de dificuldade adotado.

Utilizando as probabilidades de classificação apresentadas acima, podemos dizer que o grupo mais difícil é aquele mais imprevisível. Ou seja, em um grupo, quanto mais similares forem as probabilidades de se classificar para as Oitavas-de-final, mais difícil o grupo deve ser considerado. O exemplo extremo dessa dificuldade seria um grupo onde todos as seleções tivessem 50% de chance de classificação.

A Entropia da Informação (Information Entropy) é uma medida bastante conhecida na Estatística e na Teoria da Informação, a qual pode ser utilizada justamente para medir a “quantidade de incerteza” numa distribuição de probabilidade. Quanto mais incerteza, mais difícil de prever pois mais resultados são possíveis e consequentemente, mais difícil será o grupo. Não vamos entrar em mais detalhes aqui, mas acesse esse link se quiser mais detalhes sobre a entropia. Uma observação técnica relevante é que estamos aplicando a entropia nas probabilidades de classificação, apesar delas não formarem uma distribuição de probabilidades propriamente dita, visto que a soma das probabilidades é 2 (quando deveria ser 1). Apesar disso, a interpretação da entropia ainda é a mesma.

Na tabela abaixo calculamos a Entropia da Informação para cada grupo, e ordenamos a tabela de acordo com o ranking de entropia (dificuldade). Utilizando o critério discutido aqui nesse blog, o grupo mais difícil é o Grupo H, das seleções de Colômbia, Polônia, Senegal e Japão. Nesse caso, é interessante notar que esse grupo que é considerado o mais fraco tecnicamente por muitos especialistas, é na verdade o grupo mais difícil, por que ele será o mais disputado devida a maior similaridade técnica entres os participantes.


Depois desse grupo, o mais difíceis são, em ordem, o grupo D (da Argentina) e o grupo B (de Espanha e Portugal) empatados em segundo,  e depois o grupo E, do Brasil , F da Alemanha e C da França empatados em terceiro. O grupo mais fácil é o G, da Bélgica e Inglaterra.  Esse grupo, inclusive, é quem mais se distancia dos outros em relação a entropia. Ou seja, nessa Copa não temos um grupo da morte, mas sim um grupo da moleza!


Wednesday, February 15, 2017

Banco de dados sobre terrorismo

Após a posse do novo presidente americano Donald Trump em 20/01/2017, diversas ações do americano têm causada bastante polêmica. Talvez a medida mais polêmica de todas tenha sido a proibição da entrada nos EUA de qualquer pessoa dos seguintes países: Síria, Iraque, Irã, Líbia, Sudão, Iêmen e Somália. Detalhes sobre essa medida podem ser encontrados nesse artigo.

O que causou mais controvérsia, além do fato dessa ser uma medida extremamente arbitrária, tratando todos os cidadãos desses países como terroristas, foi a aparente falta de critério claro na escolha dos 7 países. Como pode ser visto aqui, não há registro de nenhum terrorista desses países atuando em território americano desde o ataque de 11 de setembro.

Com todas essas notícias sobre essa medida, pensei que seria interessante calcular qual é a chance de uma pessoa ser terrorista dado que ela é de um desses países. Dessa forma podemos quantificar de forma precisa o risco que se corre ao deixar cidadãos desses países entrarem em seu território. Também poderia avaliar em quais países essa chance é maior. Ou seja, poderíamos avaliar se têm sentido as escolhas feitas por Trump.

Para fazer essas contas, precisamos apenas do Teorema de Bayes e da nacionalidade dos terroristas, além do tamanho populacional dos países envolvidos. Pra minha tristeza, não consegui encontrar a nacionalidade dos terroristas.

Por outro lado, encontrei uma grande quantidade de informações em bases de dados sobre terrorismo, como pode ser visto nesse site, na seção "Data Sources". A análise que eu queria fazer não é possível ainda, mas muitas outras podem ser realizadas com esses dados, por isso resolvi ajudar na divulgação dos mesmos para que o assunto possa ser melhor estudado.

Mas ainda tenho esperança que informações sobre a nacionalidade dos terroristas sejam coletadas, pois ajudariam muito na discussão dessa medida polêmica adotada pelo Trump.

Tuesday, January 31, 2017

É "justo" que a premiação do tênis para torneios masculinos e femininos seja igual?


Desde 2007, a ATP (associação de tenistas profissionais) oferece a mesma premiação para homens e mulheres nos principais torneios de simples do planeta. Esse fato causa alguma controvérsia, como pode ser visto nesse link, pois questiona-se se é justo que homens e mulheres recebam o mesmo valor para vencer esses torneios. O principal argumento utilizado é que o torneio masculino arrecada mais dinheiro (público/audiência/patrocinadores), e sendo assim os homens deveriam receber mais dinheiro pela conquista.

Uma outra diferença importante é que os jogos dos principais torneios são disputados no sistema melhor de 3 sets para as mulheres, e melhor de 5 sets para os homens. Ou seja, no geral os homens têm que jogar mais sets para ganhar o campeonato do que as mulheres. Apenas para exemplificar, no torneio de Wimbledon de 2016, o Andy Murray ganhou o torneio masculino disputando 23 sets, enquanto a Serena Williams ganhou o feminino disputando 15 sets.

Nesse post vou ignorar todas as questões comerciais, e apenas pensar sobre o esforço que cada atleta têm que fazer para ganhar o torneio. Nesse contexto, a premiação justa deveria levar em conta o esforço médio realizado por um homem e por uma mulher para vencer o torneio. Se os níveis de esforço forem similares, a premiação também deve ser. Se forem muito diferentes, essa diferença deveria ser levada em conta na distribuição dos prêmios.

Se o esforço da mulher para disputar 3 sets for equivalente ao esforço do homem para disputar 5 sets, então as premiações devem ser iguais. A dificuldade então reside em como avaliar, de forma justa, o nível de esforço dos atletas. Claramente não existe uma forma definitiva de avaliar isso, devido a tremenda complexidade das diferenças entre homens e mulheres. Sem falar das nuances de cada esporte e das diferentes estratégias de jogo de cada jogador.  Mesmo sabendo dessas limitações na análise, qual seria uma forma razoável de avaliar o nível de esforço?

Na grande maioria dos esportes homens e mulheres disputam torneios separadamente. Isso ocorre porque a velocidade, a força, o reflexo de homens e mulheres são diferentes. Seus corpos são muito diferentes. Separando as competições de acordo com o sexo faz com as disputas sejam mais justas e equilibradas para todos os atletas. Como exemplo, no atletismo é fácil avaliar a diferença de performance entre os sexos, como mostramos na tabela 1 abaixo, que compara os tempos dos recordes mundiais para as principais distâncias de corrida.

Distância
Homem
Mulher
Diferença %
100 m
0'9''58
0'10''49
9.5%
200 m
0'19''19
0'21''34
11.2%
400 m
0'43''03
0'47''6
9.4%
800 m
1'40''9
1'53''3
12.9%
1 km
2'12''0
2'29''0
12.9%
1,5 km
3'26''0
3'50''1
11.7%
2 km
4'44''8
5'25''4
14.4%
3 km
7'20''7
8'06''1
10.4%
5 km
12'37''4
14'11''2
12.4%
10 km
26'17''5
29'17''4
11.4%
20 km
55'21''0
60'01''54
8.4%
Meia Maratona (21 km)
58'23''0
60'05''09
2.9%
Maratona (42 km)
120'02''57
120'17''42
0.2%
100 km
360'13''33
360'33''11
0.1%

Dessa tabela percebemos que o desempenho relativo entre os sexos se aproxima, quanto maior for a distância. Na corrida de 100m, por exemplo, o tempo das mulheres é 9.5% mais lento que o dos homens. Já no caso da maratona, a diferença é de apenas 0.2%. Ou seja, dependendo da distância percorrida, a diferença relativa entre os tempos é diferente.

Se fizermos a suposição (bastante forte) de que os níveis de esforço dos atletas são proporcionais aos tempos dos recordes mundiais de atletismo, podemos utilizar essas diferenças para avaliar o esforço relativo dos atletas numa partida de tênis. Num jogo de tênis masculino, os jogadores usualmente correm entre 4 e 10 km, como pode ser visto nesse link. Nessa faixa, destacada em amarelo na tabela acima, vemos que o desempenho das mulheres é, em média, 12% inferior ao dos homens. Utilizando esse valor como referência, podemos dizer que uma partida de tênis feminina deveria ter 88% da duração da partida de tênis masculina para que o nível de esforço fosse similar.

Como as mulheres disputam no máximo 3 sets e os homens 5 sets, podemos supor que em média as mulheres disputam apenas 60% dos sets que os homens disputam. Claro que esse percentual pode oscilar bastante, dependendo de competitividade nos torneios entre outros, porém aqui quero simplificar a análise ao máximo (alguém com interesse pode refazer essa análise utilizando o número médio de sets que homes e mulheres jogam). Pelo nosso critério acima, o justo seria que a mulher jogasse 88% dos sets que os homens jogam. Assim temos que o esforço relativo da mulher está 28% abaixo do esforço do homem. Por esse critério, a premiação feminina deveria também ser 28% inferior.

Se os torneios femininos passassem a ser jogados no sistema melhor de 5 sets como no caso dos homens, qual deveria ser a premiação de cada sexo? Nesse caso, temos que as mulheres estão jogando 100% dos sets masculinos, porém o justo seria jogarem apenas 88%. Ou seja, nesse cenário elas se esforçam 12% a mais do que os homens, então também deveriam receber uma premiação 12% maior. Ambos esses cenários foram resumidos na tabela abaixo.


Cenário 1
Cenário 2
Sets Disputados Mulheres
3
5
Sets Disputados Homens
5
5
Esforço realizado (# sets Mulheres/Homens)
60%
100%
Esforço "ideal"
88%
88%
Diferença
-28%
12%

Escrevi esse post porque tive uma conversa com uma amiga minha sobre essa questão do tênis, e ficamos pensando como poderíamos medir esse esforço. Depois da conversa fiquei pensando sobre isso e tive a ideia de utilizar os tempos dos recordes mundiais. Minha análise aqui é bem “simplista”, mas mostra como é possível utilizar uma variável “proxy” para medir algum fator difícil de ser mensurado/observado.

Claro que tanto a variável quanto o critério de comparação utilizado podem ser melhorados, porém nesse post vemos como mesmo com uma análise simples e subjetiva é possível obter insights sobre o tema sendo estudado. E o melhor é que essa análise pode ser continuamente refinada, melhorando tanto o nosso entendimento do assunto quanto as estimativas obtidas. Até por isso eu não utilizaria esses resultados para pedir a ATP que redefina as premiação. Porém essa análise mostra que pode existir alguma verdade por trás da polêmica, e que talvez esse tema devesse ser estudo com seriedade pela ATP.

Thursday, December 8, 2016

Na Copa do Brasil, é mais vantajoso jogar o primeiro ou o segundo jogo em casa?

O site PollingData (http://www.pollingdata.com.br/) recentemente passou a acompanhar alguns campeonatos de futebol do Brasil, porém meu interesse por futebol é bem mais antigo. Uma das minhas dúvidas mais antigas que combinam futebol e estatística está relacionada a campeonatos de futebol onde o número de gols fora de casa é utilizado como critério de desempate.

No geral, parece haver um consenso de que numa disputa de ‘mata-mata’ (onde dois times fazem um jogo em casa e um jogo fora), jogar o último jogo em casa é mais vantajoso. Porém no contexto onde o gol fora de casa vale mais, será que ainda é mais vantajoso jogar o segundo jogo em casa? Minha sensação é de que dessa forma o resultado do segundo jogo acaba sendo distorcido, e que talvez seja melhor jogar o primeiro jogo em casa, sem as distorções causadas pelos gols fora de casa no jogo anterior. Sem contar que no segundo jogo, quem tem a vantagem de fazer “gols fora de casa” é o time que jogou o primeiro jogo em casa.

Para verificar se de fato jogar o segundo jogo é mais vantajoso nesse contexto, decidir analisar os resultados de todos os jogos de todas as Copas do Brasil disputadas até hoje (28 campeonatos disputados entre 1989 e 2016). Baixei todos os dados do site ogol utilizando a biblioteca rvest do R, que é muito boa e simples de usar. Minha maior dificuldade foi que o site começou a não permitir meu acesso, desconfiando (com razão) que não fosse um humano, e sim um programa que estava acessando os dados J

Hoje em dia a Copa do Brasil conta com 86 times, de todas as divisões do futebol brasileiro, então claramente existe uma diferença muito grande de qualidade entre os times. Tanto que na primeira fase, os times de menor expressão jogam o primeiro jogo em casa, e se perderem por 2 gols de diferença ou mais em casa, são eliminados sem realizar o jogo de volta.

Como não tenho muito tempo para fazer essa análise, porém quero evitar que minhas estimativas de chance de vitória tenham seus efeitos confundidos por causa do diferencial técnico entre os times, vou tomar o cuidado de analisar separadamente os jogos realizados a partir das oitavas de final. Estou supondo que a partir dessa fase, os times classificados têm um nível técnico mais similar. Claro que existem outros fatores que também podem influenciar os resultados, como cartões, expulsões, dois times da mesma cidade, outros campeonatos ocorrendo em paralelo, porém esses fatores não serão controlados aqui.

Na tabela abaixo, calculei o percentual de vezes que os times jogando em casa o primeiro ou o segundo jogo venceram a disputa, distinguindo entre as diferentes fases do campeonato. Fica evidente que ao analisar todas as fases conjuntamente, jogar o segundo jogo em casa é, em média, duas vezes melhor do que jogar o primeiro jogo em casa. Mesmo olhando apenas as fases finais (com exceção da grande final), com os times mais parelhos, a vantagem ainda é de jogar a partida final em casa, porém em grau bem menor. De cada 17 duelos, apenas 1 a mais será ganho pelo time jogando a última partida em casa.


Talvez a estatística mais interessante da tabela seja relacionada a final do campeonato. Na disputa final, não esquecendo que temos uma amostra menor, a relação parece ser ao contrário. Ou seja, na final é mais vantajoso jogar a primeira partida em casa. Por mais que apenas esse resultado vá de encontro ao que eu esperava, é difícil encontrar uma explicação para essa inversão apenas nessa disputa. Talvez os times visitantes entrem em campo mais cautelosos no primeiro jogo e façam menos gols fora de casa, dando dessa forma uma vantagem para quem joga a primeira em casa.Talvez seja por causa da pressão do time que joga em casa*. Independente de qual hipótese é correta, os dados mostram que no jogo de ida das finais, 53% das vezes o time visitante não fez gol. Um percentual bem alto se comparado com a média geral do campeonato, considerando todas as fases, que é de apenas 28%.


Para finalizar, me parece interessante apresentar uma tabela (acima) com as chances de vitória do time que joga o primeiro jogo em casa dependendo do número de gols marcados no primeiro jogo (tanto pelo time de casa quanto o visitante).  Nessa tabela estamos considerando apenas as fases finais do campeonato. Se de fato na final os times visitantes no primeiro jogo tendem a ser mais conservadores, e não fazerem gols, vemos que a probabilidade de vitória para os mandantes do primeiro jogo,  quando não sofrem gols,  é de 54%.

Fica claro dessa análise que a minha hipótese inicial, de que é mais vantajoso jogar o primeiro jogo em casa, não é verdade na maioria dos casos, com exceção da grande final.  Por isso que estatística é tão interessante, podemos empiricamente compreender o mundo em que estamos, testar hipóteses e aprender com isso. Na minha próxima conversa de boteco, meu discurso sobre o 'gol fora de casa'  será outro!

*Vale ressaltar que em 2015 o regulamento da Copa do Brasil foi alterado, e a partir desse ano gol fora de casa não é mais critério de desempate na final. Esse fato poderia afetar os resultados e ajudar a explicar porque na final os resultados parecem invertidos, porém dos 28 embates na base de dados, apenas os dois últimos ocorreram com as novas regras.


Friday, November 25, 2016

PollingData agora está prevendo o resultado do Campeonato Brasileiro de 2016

O site PollingData (http://www.pollingdata.com.br/) acabou lançar uma novidade: estamos prevendo os resultados dos jogos do Brasileirão 2016 – Série A. O campeonato está quase no final, mas como as eleições americanas e brasileiras terminaram, decidimos testar nossos modelos de previsão em outros eventos.

Estamos usando um modelo hierárquico bayesiano (baseado na Poisson bivariada). Por enquanto o modelo é bem simples, mas a forma como foi construído permite que o modelo incorpore facilmente novas informações para prever os resultados dos jogos, como por exemplo levar em conta que um time está numa trajetória ascendente/descendente (aguarde por futuras atualizações).

Com o nosso modelo calculamos as chances de ganhar o campeonato, de classificação para a Libertadores, de rebaixamento, além das probabilidades de vitória/empate/derrota para todos os jogos que ainda não foram realizados. Também incluímos um gráfico iterativo, que permite comparar a trajetória de diferentes times ao longo do campeonato. O site será atualizado ao final de todas as rodadas, então não deixe de acessar o site regularmente para ver quais times ganharão na próxima rodada!


Se você tem interesse em previsões de campeonatos de futebol, recomendamos o site Chance de Gol, do Marcelo Arruda, que é especialista no assunto e acompanha os principais campeonatos do mundo. Seu site está no ar há mais de 10 anos, e é a fonte que nós consultamos para validar o modelo de previsão de futebol do PollingData. Outra referência interessante é o site Previsão Esportiva, do pessoal de São Carlos.

Friday, October 14, 2016

PollingData acompanhando o segundo turno das eleições municipais de 2016

Hoje o site PollingData (http://www.pollingdata.com.br/) começa oficialmente a acompanhar as pesquisas do segundo turno das eleições municipais de 2016. Nesse momento estamos acompanhando 40 eleições municipais, com mais de 170 pesquisas do segundo turno incluidas em nosso acervo. 

Todas as eleições sendo acompanhadas, as previsões, as probabilidades de vitória e os gráficos com os vieses dos institutos estão no menu “Eleições 2016 > Brasil” que pode ser acessado diretamente pelo link http://www.pollingdata.com.br/#br2016. No Dashboard do site, na aba “Eleições 2016 (Brasil)”, disponibilizamos uma tabela resumo com os resultados de todas as capitais.


Também atualizamos as previsões do resultado da eleição americana de 2016. Agora estamos acompanhando pesquisas de todos os 51 estados, além das pesquisas nacionais. No Dashboard do site, na aba “Eleição Geral (EUA)”, disponibilizamos uma tabela resumo com os resultados de todos os estados. Para ver detalhes das previsões, acesse o link http://www.pollingdata.com.br/#us2016G.

Friday, October 7, 2016

Incluindo o resultado do primeiro turno das eleições municipais de 2016

O site PollingData (http://www.pollingdata.com.br/) foi atualizado com o resultado do primeiro turno das eleições municipais de 2016. Agora você pode ver em um único gráfico toda a história de cada eleição, com todas as pesquisas publicadas e também com o resultado do pleito. Os gráficos atualizados encontram-se no menu “Eleições 2016 > Brasil” que pode ser acessado diretamente pelo link  http://www.pollingdata.com.br/#br2016.
Na semana que vem, faremos uma avaliação da performance das pesquisas eleitorais no primeiro turno, e as pesquisas do segundo turno também serão incluídas no site. Não deixe de acessar o site para conferir!

Sunday, October 2, 2016

Previsão atualizada do primeiro turno das eleições municipais de 2016

O site PollingData (http://www.pollingdata.com.br/) foi atualizado com as pesquisas eleitorais mais recentes das seguintes cidades: São Paulo, Rio de Janeiro, Belo Horizonte, Recife, Fortaleza, Salvador, Curitiba, Goiânia, Belém, João Pessoa, Vitória, Campinas, Ribeirão Preto, Santos e Feira de Santana.

Acesse o site para ver a previsão atualizada do resultado da eleição na sua cidade. Nesse momento estamos acompanhando 113 eleições municipais, com mais de 420 pesquisas do primeiro turno incluídas em nosso acervo.

Saturday, October 1, 2016

Prevendo o primeiro turno das eleições municipais de 2016

O site PollingData (http://www.pollingdata.com.br/) foi atualizado com as pesquisas eleitorais mais recentes. Acesse o site para ver a previsão do resultado da eleição na sua cidade.

Nesse momento estamos acompanhando 113 eleições municipais, com mais de 410 pesquisas do primeiro turno incluídas em nosso acervo. Para facilitar o acesso as previsões, estamos disponibilizando duas formas diferentes de visualização dos resultados das capitais: uma através de um mapa interativo e outra através de uma tabela. Ambos os formatos podem ser encontrados no Dashboard do site.

 Além disso, para todas as eleições sendo acompanhadas, as previsões, as probabilidades de vitória, os gráficos com os vieses dos institutos estão no menu “Eleições 2016 > Brasil” que pode ser acessado diretamente pelo link  http://www.pollingdata.com.br/#br2016.

Na semana que vem, as pesquisas do segundo turno também serão incluídas no site. Não deixe de acessar o site para conferir!

Monday, September 12, 2016

PollingData está acompanhando as eleições municipais de 2016

Hoje o site PollingData (http://www.pollingdata.com.br/) começa, de fato, a acompanhar as pesquisas municipais de 2016. Após a oficialização das condidaturas em agosto, foi possível filtrar cenários e pesquisas que não são mais relevantes, e focar apenas naquelas que são mais informativas para prever o resultados dessas eleições.

Nesse momento estamos acompanhando 95 eleições municipais, com mais de 320 pesquisas do primeiro turno incluidas em nosso acervo.  Como são muitas eleições, estamos priorizando a divulgação de informações sobre as capitais estaduais. Para facilicar o acesso as previsões, estamos disponibilizando duas formas diferentes de visualização dos resultados dessas capitais: uma através de um mapa interativo e outra através de uma tabela. Ambos os formatos podem ser encontrados no Dashboard do site.

Além disso, para todas as eleições sendo acompanhadas, as previsões, as probabilidades de vitória, os gráficos com os vieses dos institutos estão no menu “Eleições 2016 > Brasil” que pode ser acessado diretamente pelo link http://www.pollingdata.com.br/#br2016.


Assim que for possível, as pesquisas de simulação do segundo turno também serão incluídas. O site será atualizado constantemente, então não deixe de acessá-lo para acompanhar as previsões mais recentes e conhecer o cenário político atualizado da sua cidade. 

Wednesday, June 22, 2016

Referendo sobre a permanência do Reino Unido na União Européia

Com todas as notícias relacionadas ao Impeachment, a crise  e a corrupção no Brasil sendo divulgadas constantemente na mídia, sobra pouco espaço para dar o devido destaque ao referendo popular que será votado amanhã no Reino Unido (RU). Para quem não sabe, nesse referendo os britânicos irão decidir se o RU permanece na União Européia (UE) ou não. O impacto de uma decisão de deixar a UE pode ser enorme, desde colocar em xeque a existência da UE à causar a saída da Escócia do RU.

Muitas pesquisas têm sido feitas para prever qual será o resultado da votação (link), porém por causa dos erros cometidos pelos institutos de pesquisa ao prever os resultados das eleições gerais no RU em 2015 (veja aqui), existe muita desconfiança sobre a confiabilidade das pesquisas. A maioria das pesquisas publicadas recentemente indica um empate técnico entre “Permanecer” e “Sair” da UE, com um percentual médio de 10% de indecisos. Ou seja, os indecisos podem facilmente decidir o referendo.

Uma outra incógnita muito importante é saber quem irá votar no referendo. Como não é uma eleição tradicional, é muito difícil avaliar quantas pessoas de fato comparecerão as urnas para votar. A chance de comparecer as urnas pode estar relacionada a permanência ou saída da UE, tornando a dificuldade de prever o resultado ainda maior.

Mesmo confiando no resultado das pesquisas, existe uma outra complicação importante.  No RU têm sido utilizadas duas metodologias principais para se fazer as pesquisas sobre o referendo: online e telefônica. E os resultados das duas metodologias têm sido consistentemente diferentes, sendo as pesquisas online mais favoráveis a saída da UE e as telefônicas mais favoráveis a permanência na UE.

De acordo com esse site, a diferença entre as metodologias ocorre porque na pesquisa telefônica, o entrevistador não dá a opção ao respondente de escolher “Não Sabe” ou “Não têm opinião”, forçando o mesmo a escolher um dos lados. Já nas pesquisas online, que são auto-preenchidas, o respondente pode escolher essas opções neutras, sem se posicionar a favor ou contra. O consenso têm sido de que ao forçar o respondente a escolher um dos lados, existe uma tendência maior dele escolher a opção mais familiar, ou o status quo, nesse caso de permanência na UE.

O site PollingData têm acompanhado as pesquisas do referendo do RU, porém não de forma pública. Nesse post vamos mostrar as previsões atualizadas do site utilizando dois modelos diferentes, descritos abaixo:

1-      Tradicional (sem memória) - Esse é o modelo que o site já vem utilizando á alguns anos. O principal problema com esse modelo têm side que ele supõem que a intenção de voto se manterá constante após a última pesquisa. Ou seja, assume que o cenário eleitoral se manterá constante. Denominamos esse modelo de sem memória porque não importa se um candidato estava na ascendente/descendente, a previsão do modelo irá ignorar essas tendências e supor que o cenário de hoje se repetirá amanha.
2-      Novo (com memória) – Esse é um novo modelo em ainda em desenvolvimento, e essa será a primeira vez que iremos utilizá-lo em uma situação real. Esse modelo assume que as tendências de subida/queda dos candidatos se manterão após a última pesquisa divulgada. A motivação para desenvolver esse modelo ocorreu em 2014, quando em muitas eleições ficou evidente que as estimativas seriam mais precisas se as tendências de cescimento/queda  que ocorreram as vésperas das eleições fossem levadas em conta na hora de fazer as previsões. Por isso esse modelo foi denominado de com memória.

No Brasil usualmente não existem informações claras sobre as metodologias de pesquisa utilizadas, assim o tipo de metodologia não têm sido utilizada nos modelos descritos acima. No caso das pesquisas sobre o referendo popular, a informação sobre a metodologia utilizada existe, assim adaptamos os modelos do PollingData para levarem em conta essa informação que claramente é bastante informativa.

Ao acrescentar essa informação, os modelos estimam o viés causado por cada tipo de metodologia, e implicitamente assumem que a intenção de voto está na realidade entre as estimativas obtidas pelas diferentes metodologias (ou seja, supomos que em média o viés é zero, caso contrário o modelo não é identificável). Se futuramente ficar comprovado que as pesquisas online tinham um viés e as telefônicas não eram enviesadas, por exemplo, o modelo fatalmente errará a previsão, pois ele considera que as duas metodologias trazem informações importantes sobre o cenário eleitoral.

Abaixo apresentamos um gráfico para cada modelo. Como a diferença entre os dois modelos é sutil, porém bastante importante, destacamos em preto a diferença nas previsões do resultado das eleições.


Utilizando o modelo tradicional as estimativas para o dia da eleição estão empatadas em 46%, com probabilidade de vitória de 50% para cada. Porém utilizando o modelo novo, com memória, ele capta o aumento recente da opção por “Continuar” onde as estimativas são de 49% de “Continuar” e 45% de “Sair”, com probabilidade de vitória de 73% para “Continuar”. A diferença entre os dois modelos é bem grande. O mercado de pesquisas está obtendo estimativas mais parecidas com o modelo sem memória, porém eu acho que o modelo com memória está captando a mudança da intenção de voto que está ocorrendo de última hora. Baseado nas estimativas dos modelos, minha previsão é de que o resultado do referendo será de continuar na UE, mas de fato esse e´ um teste bastante duro para o novo modelo....

Como curiosidade, segue abaixo a tabela com o viés estimado por tipo de metodologia.


Update 23/6/2016 9am:

Hoje foram divulgadas 4 novas pesquisas que foram encerradas ontem. Re-estimando os modelos incluindo essas pesquisas, obtemos os seguintes resultados. Pelo "modelo SEM memória", percentual de votos previsto é de 46% para continuar e 45% para sair, com probabilidade de vitória de 57% para continuar. Já para o "modelo COM memória", percentual de votos previstos é de 47% para continuar e 45% para sair, com probabilidade de vitória de 66% para continuar.

O motivo pelo qual os resultados dos modelos estão mais similares após essa atualização é porque existe apenas um dia entre a última pesquisa divulgada e o dia da eleição, e pelas suposições do modelo a opinião pública não pode se alterar tanto em apenas um dia. Além disso, a precisão da estimativa do dia 22 (ontem) é bem alta, porque foram observadas quatro pesquisas.


Update 23/6/2016 11am:

Por enquanto foram divulgadas 7 novas pesquisas que foram encerradas ontem. Re-estimando os modelos incluindo essas pesquisas, obtemos os seguintes resultados. Pelo "modelo SEM memória", percentual de votos previsto é de 46% para continuar e 46% para sair, com probabilidade de vitória de 51% para continuar. Já para o "modelo COM memória", percentual de votos previstos é de 46% para continuar e 45% para sair, com probabilidade de vitória de 56% para continuar.


Tuesday, May 24, 2016

PollingData Educativo....

O PollingData está lançando um nova iniciativa. Agora estamos publicando textos educativos, sobre Estatística, Amostragem e o uso do software R. Esse projeto apenas se iniciou, porém a ideia é que ganhe corpo, e ajude a divulgar e desmistificar a estatística.


Os textos educativos se encontram na aba “Educativo / Tutoriais” no menu principal. Espero que gostem da novidade ;)

Thursday, May 19, 2016

Performance do modelo de previsão do Impeachment no Senado Federal
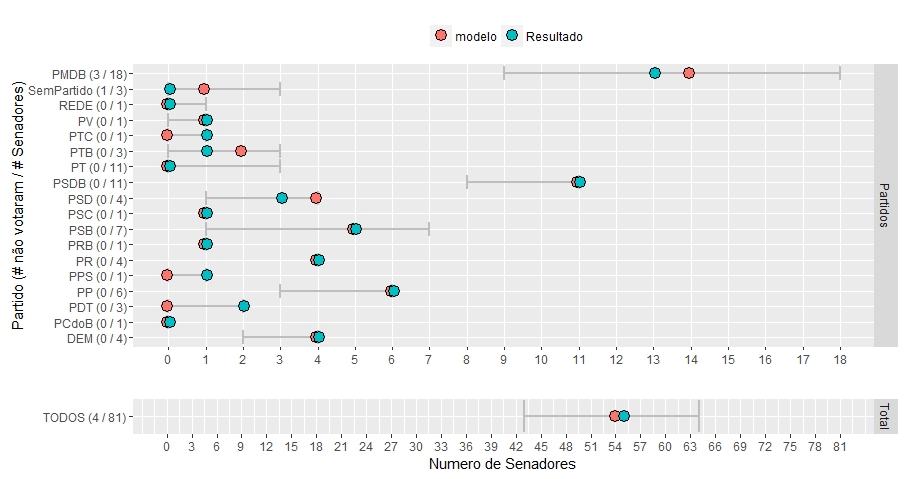
Na última quinta-feira, no Senado Federal foi realizada a votação para abertura do pedido de Impeachment da presidenta Dilma. O resultado final da votação foi de 55 votos a favor de um total de 77 votos. Com essa decisão,  a presidenta fica afastada do mandato até o julgamento final pelo Senado, o que pode levar até 180 dias, .

O PollingData fez um modelo para prever o resultado dessa votação baseado apenas no histórico de votação de cada Senador e também na votação dos Senadores que participaram da Comissão Especial do Impeachment. Os 20 votos de senadores que participaram da Comissão foram fixados, pois estávamos supondo que o voto na comissão seria o mesmo da sessão da última quinta-feira. Os votos de todos os outros 61 Senadores foram previstos utilizando apenas o histórico de votação no Senado e posição dos Partidos / Líderes de cada partido.

A previsão desse modelo era que o número de votos a favor seria de 54 (intervalo de previsão entre 43 e 64 votos), com probabilidade de 100% da abertura do pedido de Impeachment ser aprovada. Prever que o pedido seria aprovado foi relativamente fácil devido ao contexto extremamente favorável ao pedido. Porém acertar com tanta precisão a estimativa pontual de votos é um feito considerável.

Para avaliar melhor a performance do modelo, construímos o gráfico abaixo, comparando a previsão do modelo por partido com o resultado da votação (no gráfico estamos analisando o número de votos favoráveis).


Todos os resultados estavam dentro dos intervalos de previsão. Para partidos que têm somente um Senador, esse não é um grande feito pois usualmente o intervalo incluía todos os possíveis resultados (0 ou 1 voto favorável). Porém para partidos maiores é um ótimo resultado. Mesmo estando dentro do intervalo de previsão, o partido com a pior performance foi o PDT, onde erramos por 2 votos, para todos os outros casos, erramos no máximo por apenas 1 voto.

Os dados disponíveis nos sites do Governo sobre as votações dos Senadores e dos Deputados são razoavelmente diferentes, incluindo as informações disponíveis. Para desenvolver o modelo da Câmara, para toda votação existe um posicionamento oficial do Governo e de cada partido. Já para o caso do Senado, essa informação não existe. Ela teve que ser derivada avaliando o voto do líder de cada bancada.  Além disso, muitas votações no Senado são fechadas, então existe menos informação disponível para ser utilizada no modelo.

Por esses motivos, consideramos que prever o resultado da votação no Senado era mais difícil do que na Câmara. Como a previsão no Senado teve uma performance melhor do que na Câmara, estamos muito satisfeitos com esse resultado!


Monday, April 18, 2016

Performance do modelo de previsão do Impeachment na Câmara dos Deputados

Como quase todo brasileiro deve saber, ontem foi realizada a votação na Câmara dos Deputados para aprovação do pedido de Impeachment da presidenta Dilma. O resultado final da votação foi de 367 votos a favor de um total de 513 votos.

O PollingData fez um modelo para prever o resultado dessa votação baseado apenas no histórico de votação de cada deputado. A previsão desse modelo era que o número de votos a favor estaria entre 312 e 366, com probabilidade de 67% da votação do Impeachment ser aprovada. Se considerarmos que para acertar a previsão o número de votos (367) deveria estar contido dentro do intervalo divulgado (312-366), estritamente falando, o nosso modelo errou a previsão.

Mais importante que classificar a previsão como correta ou não, é tentar descobrir onde o modelo falhou, para ajustá-lo, de forma a poder re-utilizar a mesma metodologia para prever a votação do Senado. Para avaliar onde erramos, comparamos as previsões do modelo com a votação para cada partido. Essa comparação pode ser vista no gráfico abaixo.


Fica evidente que o modelo teve um erro maior em 3 partidos: PR, PMDB e PTB. No caso do PMDB, mesmo tendo um erro de 5 votos  favoráveis a menos, o intervalo de nossa previsão contém o resultado da votação, ou seja, não foi propriamente um erro, apenas nossa previsão não era muito precisa. Já nos casos do PR e do PDT, a previsão de fato não contém o resultado da votação. Esses dois casos podem ser vistos como um erro da previsão.

Especificamente no caso do PR, onde subestimamos em 13 os votos favoráveis, a posição do partido não ficou bem definida antes da votação, como pode ser visto nestas notícias (link1, link2 e link3). Oficialmente a posição foi contraria ao Impeachment, porém o presidente do partido deixou o partido para poder votar a favor do Impeachment, alegando que mais de metade do partido era também favorável. Por esse motivo na última previsão do modelo, classificamos o PR como tendo a posição “LIVRE”. Mas na realidade, ficou evidente que a posição de fato assumida pelos deputados foi favorável ao Impeachment, tanto que 67% dos votos do PR foram “SIM”.

Fazendo essa pequena alteração no modelo, classificando o PR como “SIM”, já teríamos uma previsão bem melhor. Essa performance pode ser vista no gráfico abaixo.  O modelo passa acertar a previsão do PR, passando agora a superestimar os votos favoráveis dos deputados desse partido. Algo esperado visto a divisão entre esses deputados. Com essa alteração, passamos a ter uma previsão do total da votação de 363, muito próximo do valor real, que foi 367.


Mesmo essa simples alteração corrigindo a previsão do modelo, fica evidente que nos partidos mencionados, o padrão de votos dos deputados deve ter se alterado nos últimos meses devido a grande pressão exercida pelo governo e pela oposição, além das mudanças de posição oficial. Para melhorar esse modelo, talvez seja interessante utilizar uma série histórica menor, ou então estimar um modelo de ponto de mudança. A primeira alternativa é mais simples, porém nem sempre é vantajoso tentar reduzir viés quando o efeito colateral é aumentar a variância. A segunda alternativa é mais complicada, porém pode ser mais eficiente.  Essa escolha só será feita quando o modelo para o Senado for desenvolvido.